martes, 27 de abril de 2010

Spotify+Facebook


Hoy se estrena Spotify 0.4 con numerosas novedades entre las que destaca su unión con Facebook.

Gracias a esta unión, Spotify trae una serie de funciones sociales como por ejemplo: tener un perfil musical de Spotify que puedes editar, publicar listas de reproducción, publicar artistas favoritos, las canciones que más escuchas, etc.

Además de todo esto, esta nueva versión también incluye el poder gestionar y reproducir toda nuestra música que tengamos en el PC.

Podeis ver muchas otras características que incluye en su blog oficial.


Si aun no se os ha actualizado solo, podeis descargarlo de la página principal de Spotify.


PD: Voy a modificar el gadchet de Twitter que tengo en la columna de la derecha. Ahora en vez de buscar lo que la gente habla sobre Google Wave buscará sobre Spotify ;)

jueves, 22 de abril de 2010

Eyjafjallajokull

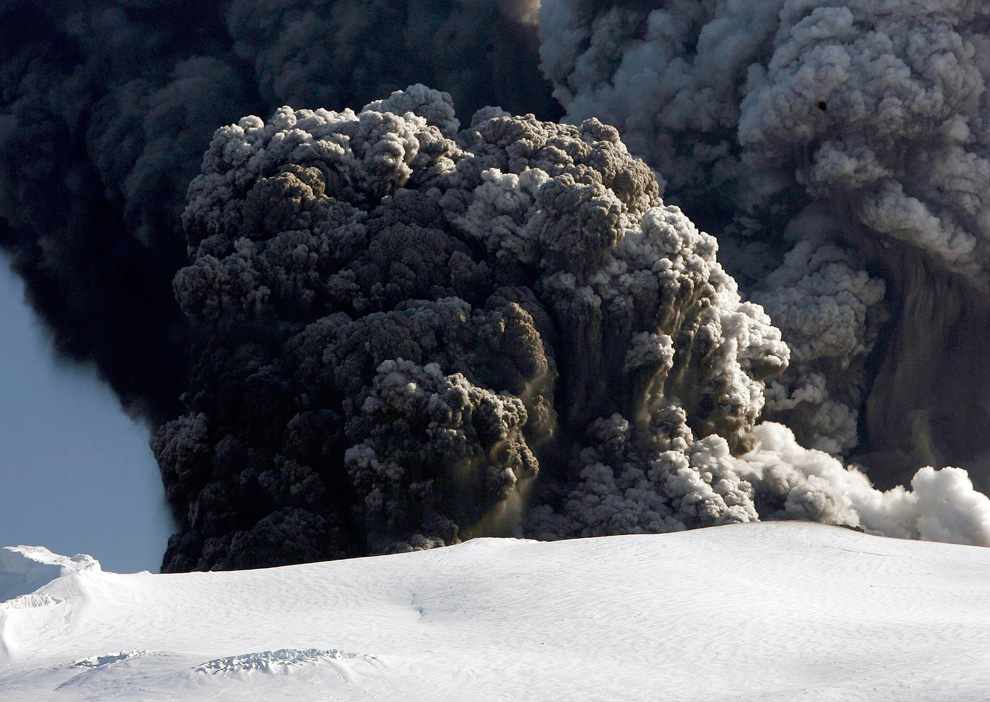
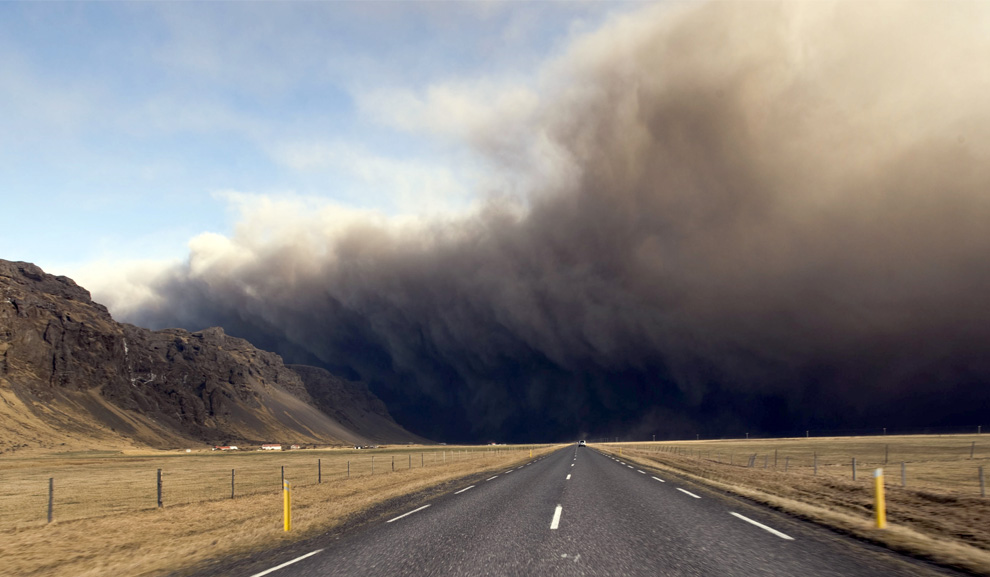
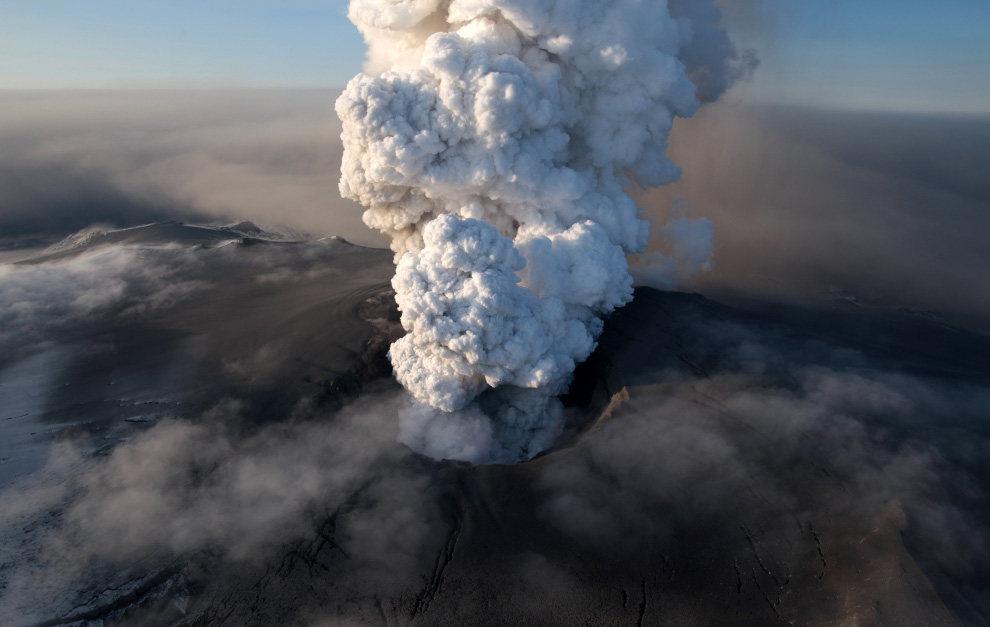
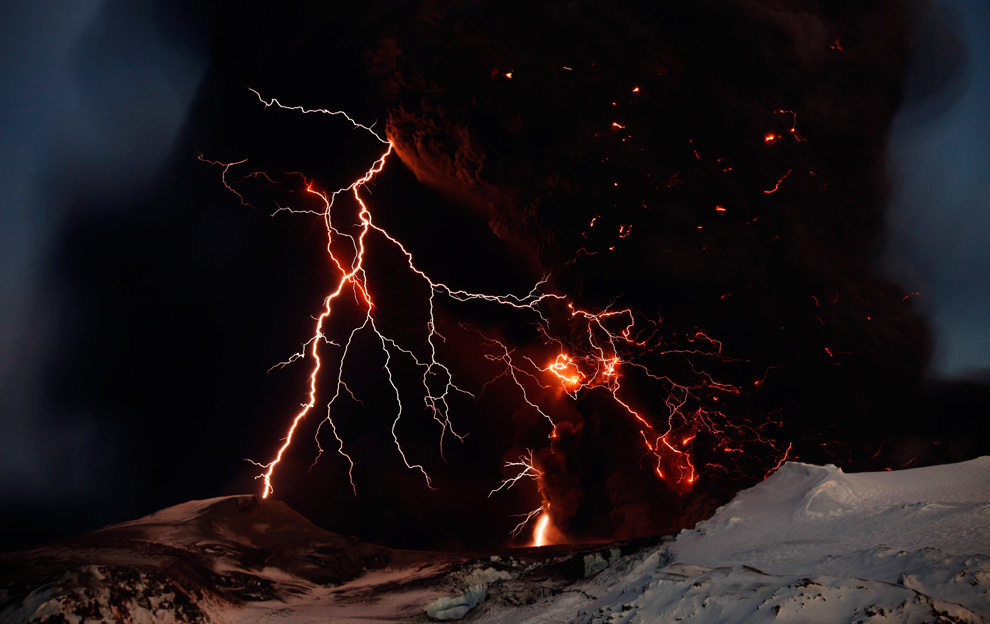
Que coincidencia que unos días despues de que publicase en el blog algunas fotos sobre volcanes en erupción, el volcán Eyjafjallajokull en Islandia decida unirse al repertorio. Y lo ha hecho haciendose notar, tanto que ha provocado que se cancelen miles de vuelos en Europa.

Aqui os dejo algunas fotos espectaculares de este volcán tomadas durante estos días:


Podeis ver muchas más fotos pinchando aqui

jueves, 8 de abril de 2010

Tuenti y sus API

Llevo un buen rato riendome con esta pregunta que me he encontrado en Yahoo Respuestas :


No sé si el que responde estará de broma o lo dice en serio pero casi me da algo al verlo. LOL!

Como curiosidad me he puesto a buscar la respuesta a la pregunta sobre Tuenti y sin buscar mucho, en el mismo blog de Tuenti podemos ver que utilizan varias tecnologías para desarrollar esta red social tan famosa en España. Entre ellas destacan XHTML, AJAX, C/C++, MySQL o PostgreSQL, PHP/Perl y Python.
Además está montado en un sistema Linux.

Ya metido en el tema, he encontrado más información interesante sobre Tuenti como por ejemplo que aún no han hecho pública una API para que los desarrolladores puedan crear programas que se comuniquen con la red social pero si que han aparecido algunas API "no oficiales" gracias a las cuales podemos disfrutar de "TuentiPack" por ejemplo.

Aqui dejo algunas por si alguien está interesado:

API en Visual Basic 6
API en PHP
API en Ruby


NOTA: Cuidado con estas API "no oficiales" ya que si desarrollais un programa para Tuenti con ellas y se cambia algo en la red social, os tocará cambiar vuestro programa también para que funcione con los cambios.

No tardarán mucho en sacar a la luz una API oficial, de hecho ya la hay, pero solo disponible para programadores que trabajan para Tuenti, aunque ya se ha filtrado gran parte.

sábado, 27 de marzo de 2010

jueves, 25 de marzo de 2010

Superordenador


Hoy he encontrado una noticia de un hecho que no me esperaba que ocurriese en mucho tiempo.
Es la siguiente:
Fuentes del Ministerio de Ciencia e Innovación han confirmado que España será el país elegido para ubicar el ordenador más potente del mundo, en concreto, la ciudad de Barcelona. La destinataria de esta iniciativa hace muy poco ya inauguró otra estructura de alto nivel: el sincrotrón Alba. Europa posee la firme intención de desbancar a los Estados Unidos en el liderazgo de la supercomputación, así que han planeado una estrategia para alcanzar este objetivo apoyándose en la unión de los países más poderosos del viejo continente. La estrategia consiste en comprar cada año la máquina más potente que exista en ese momento y compartirla con los socios comunitarios que están embarcados en esta aventura científica.


El ordenador español sería instalado en el Barcelona Supercomputing Center, que ya alberga uno de los equipos más potentes de Europa, el Mare Nostrum. La nueva máquina será 100 veces más poderosa que el impresionante inquilino que hoy habita en las enormes y asépticas salas del complejo. Los socios de esta Asociación para la Computación Avanzada en Europa (PRACE, en inglés), compartirán tiempo de uso de sus ordenadores. Las máquinas realizarán enormes cálculos en casi cualquier disciplina, desde la astronomía a la biología, pasando por la física, la medicina y la ingeniería de materiales. La inversión del gobierno en el PRACE está prevista en 100 millones de euros, que compartirán a medias con la Generalitat Catalana. Esta mega estructura será una de las 44 prioritarias que la Unión Europea considera imprescindibles para el avance de la ciencia y la investigación en I+D.

Es una gran iniciativa pero habrá que esperar dos años a ver que pasa.

lunes, 1 de marzo de 2010

Fotos de Volcanes

Os dejo una web con fotos de volcanes en erupción realmente impresionantes: http://mrietze.com/

Aqui teneis algunas de mis favoritas :p


domingo, 28 de febrero de 2010

Reconocimiento óptico de caracteres.

Hoy he encontrado una aplicación bastante curiosa para mi Nokia 5800 la cual te permite traducir un texto con la cámara de fotos. Me explico:

Estás en un pais extranjero y necesitas saber que significa un determinado cartel que hay en una tienda o un bar o cualquier sitio. Pues con esta aplicación basta con hacer una foto al cartel donde se vean bien las letras y esta puede traducir a tu idioma lo que pone en el cartel.

Esto me ha parecido un poco increible, pero la verdad es que funciona.

Ya sabía de la existencia de scaners que podían hacer algo parecido. Podemos escanear un folio con apuntes de clase escritos a mano y este nos lo convierte a caracteres en el PC. Pero nunca lo había visto a partir de una foto.

Tras descargarme la aplicación y ver que funcionaba me he puesto a buscar información sobre con que tipos de algoritmos se puede conseguir esto y he encontrado alguna información interesante sobre como se hace y cuales son los problemas actuales de estos algoritmos asi como algunas otras aplicaciones de este método:

Partiendo de una imagen perfecta, es decir, una imagen con sólo dos niveles de gris, el reconocimiento de estos caracteres se realizará básicamente comparándolos con unos patrones o plantillas que contienen todos los posibles caracteres. Ahora bien, las imágenes reales no son perfectas, por lo tanto el Reconocimiento Óptico de Caracteres se encuentra con varios problemas:

  • El dispositivo que obtiene la imagen puede introducir niveles de grises al fondo que no pertenecen a la imagen original.
  • La resolución de estos dispositivos puede introducir ruido en la imagen, afectando los píxeles que han de ser procesados.

  • La distancia que separa a unos caracteres de otros, al no ser siempre la misma, puede producir errores de reconocimiento.

  • La conexión de dos o más caracteres por píxeles comunes también puede producir errores.

Todos los algoritmos de Reconocimiento Óptico de Caracteres tienen la finalidad de poder diferenciar un texto de una imagen cualquiera. Para hacerlo se basan en 4 etapas:


Binarización

La mayor parte de algoritmos de OCR parten como base de una imagen binaria (dos colores) por lo tanto es conveniente convertir una imagen de escala de grises, o una de color, en una imagen en blanco y negro, de tal forma que se preserven las propiedades esenciales de la imagen. Una forma de hacerlo es mediante el histograma de la imagen donde se muestra el número de pixeles para cada nivel de grises que aparece a la imagen. Para binarizarla tenemos que escoger un umbral adecuado, a partir del cual todos los pixeles que no lo superen se convertirán en negro y el resto en blanco.

Mediante este proceso obtenemos una imagen en blanco y negro donde quedan claramente marcados los contornos de los caracteres y símbolos que contiene la imagen. A partir de aquí podemos aislar las partes de la imagen que contienen texto (mas transiciones entre blanco y negro).


Fragmentación o segmentación de la imagen

Este es el proceso más costoso y necesario para el posterior reconocimiento de caracteres. La segmentación de una imagen implica la detección de los contornos o regiones de la imagen, basándose en la información de intensidad o información espacial.

Una de las técnicas más clásicas y simples para imágenes de niveles de grises consiste en al determinación de los modos o agrupamientos (“clusters”) a partir del histograma, de tal forma que permitan una clasificación o umbralización de los pixeles en regiones homogéneas.


Adelgazamiento de las componentes

Una vez aisladas las componentes conexas de la imagen, se les tendrá que aplicar un proceso de adelgazamiento para cada una de ellas. Este procedimiento consiste en ir borrando sucesivamente los puntos de los contornos de cada componente de forma que se conserve su tipología.


Comparación con Patrones


En esta etapa se comparan los caracteres obtenidos anteriormente con unos teóricos (patrones) almacenados en una base de datos. El buen funcionamiento del OCR se basa en gran medida a una buena definición de esta etapa. Existen diferentes métodos para llevar a cabo la comparación. Uno de ellos es el Método de Proyección, en el cual se obtienen proyecciones verticales y horizontales del carácter por reconocer y se comparan con el alfabeto de caracteres posibles hasta encontrar la máxima coincidencia.


Algunas otras aplicaciones pueden ser el reconocimiento de matrículas que se utiliza en los radares o el reconocimiento de texto manuscrito.


Por cierto, la aplicación de la que hablaba era esta: ABBYY Foto Translate